人工智能与软件开发融合下,厦门企业智能系统建设的实践路径解析
过去两年,厦门软件园二期的不少技术团队都遇到同一个尴尬:业务部门催着要"智能升级",研发团队却卡在数据管道和模型部署之间反复返工。据行业调研数据显示,超过60%的企业AI项目在POC阶段表现良好,但真正进入生产环境的不足三成。这个落差背后,反映的正是人工智能与软件开发从"拼接"走向"融合"过程中的典型阵痛。
智能系统建设为何容易"半途而废"
问题的根源往往不在算法本身。传统软件开发遵循确定性逻辑,输入输出可预期;而AI模型带有概率性特征,需要持续的数据反馈和迭代。很多厦门企业在建设智能系统时,仍沿用瀑布式交付思维——需求冻结、开发、验收,结果模型上线即衰减。更现实的问题是,本地不少中型企业缺乏专职MLOps岗位,模型版本管理、特征工程复用、推理服务监控这些环节无人兜底。
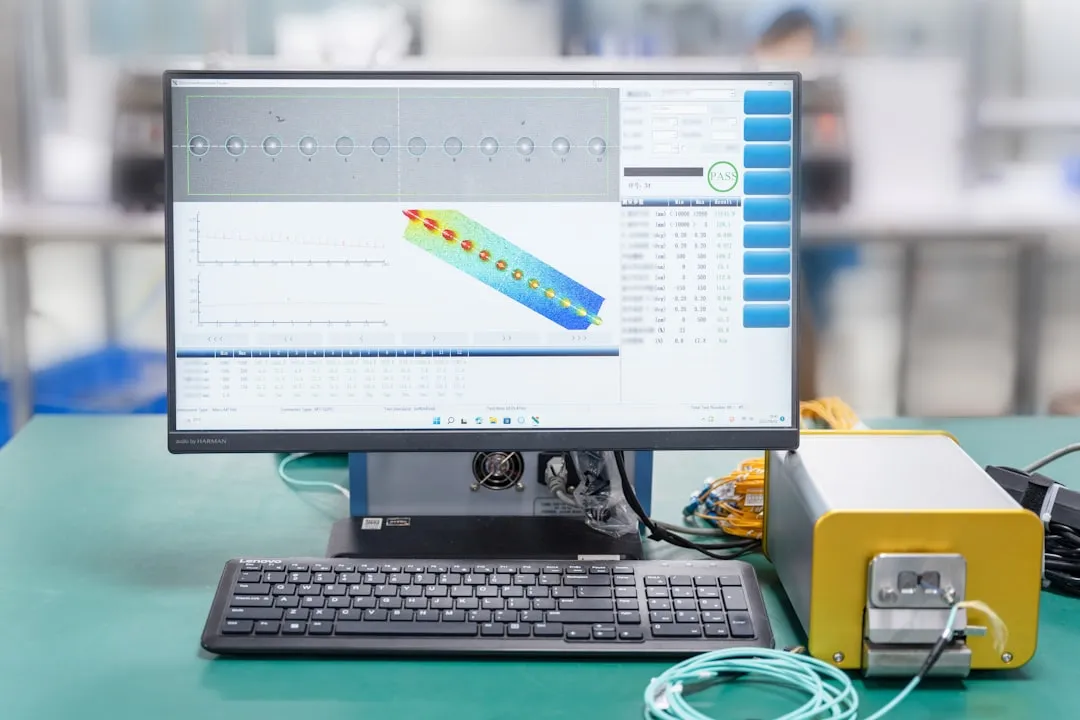
另一个容易被忽视的因素是数据资产的碎片化。ERP、CRM、生产MES各自为政,软件开发阶段没有预留统一的数据契约,等到要训练模型时才发现字段语义不一致、时间戳口径混乱。这类"技术债"在厦门科技圈的中小项目中尤为常见。
融合路径中的技术要点
真正可落地的做法,是把AI能力当作软件架构中的一等公民来设计。具体而言,有几个值得关注的工艺细节:
- 接口契约先行:在需求阶段就定义模型输入输出的schema,包括置信度阈值、降级策略,避免后期接口反复变更。
- 特征仓库与业务代码解耦:训练和推理共用同一套特征计算逻辑,减少"训练- serving skew"。
- 可观测性嵌入:不仅监控API延迟,还要追踪数据漂移和预测分布偏移,这在智能系统运维中是刚需。
以懂先生在厦门服务的制造类客户为例,质检视觉系统的交付不再是"交模型",而是交付一套包含数据回流、标注触发、灰度发布的完整流水线。这种工程化思路,让模型月均迭代次数从1次提升到4次以上。
不同建设模式的对比与选择
目前厦门企业常见的路径有三类:自建团队、采购标准化SaaS、以及与专业AI公司联合共建。自建适合数据敏感且规模足够的企业,但人力成本高;SaaS见效快,却难以贴合细分工艺;联合共建则在灵活性与成本之间取得平衡,尤其适合处于数字化中期的厦门科技企业。选择哪种模式,关键看自身数据成熟度和业务迭代频率,而非盲目追求"全栈自研"。
值得提醒的是,无论哪种路径,都要在合同中明确模型知识产权、数据使用边界和退出机制。这些条款在人工智能项目中比传统软件外包更需要前置谈判。
给技术负责人的几条实操建议
- 先用一个高频、低风险的场景做闭环验证,比如客服意图分类或工单智能分派,跑通数据回流再扩展。
- 把模型评估指标写进验收标准,准确率之外还要看召回率和误报成本。
- 建立跨职能小组,让业务方参与标注规则的制定,减少后期返工。
懂先生在多个本地项目中观察到,那些把AI当作持续运营而非一次性交付的团队,往往在半年后拉开明显差距。智能系统建设的本质,是让软件具备"学习"的组织能力,这需要工程规范、数据治理和业务理解的长期咬合。